 Sublyx Field Notes
Anthropic 于 2026 年 9 月发布 Claude Fable 5.1 和 Claude Mythos 5.1。Fable 5.1 面向通用用户和开发者开放,Mythos 5.1 则通过受信访问计划向符合条件的网络安全与生命科学组织提供。两者使用相同的底层模型,主要区别在安全限制与访问方式。
Fable 5.1 的输入和输出单价仍是每百万 token 10 美元与 50 美元,缓存读取降到 0.25 美元。但某个任务是否更便宜,不能只看缓存单价:如果模型生成更多输出 token,或者使用更高的 Effort 档位,总成本仍可能上升。生产环境应按“完成一个有效任务”的成本评估,而不是只比较价格表。
官方事实以 Anthropic 发布说明和 EFS 公告为准;独立评测数字按原文所引 Artificial Analysis 结果标注。
这次更新改变了什么
Anthropic 把 Fable 5.1 定位为面向编码、知识工作和长时间 Agent 任务的高能力模型。官方给出的 API 标识符是 claude-fable-5-1,支持 100 万 token 上下文以及图片、文本输入。Claude Code 默认使用 High effort,Claude.ai 和 Claude Cowork 默认使用 Medium effort。
与 Fable 5 相比,官方重点强调了四类变化:
- 编码、科研和业务流程基准提升;
- 缓存读取价格下降 75%;
- 引入 Enterprise Frontier Safeguards,兼顾安全监测和企业数据控制;
- 降低生物学与网络安全护栏对正常请求的误拦截。
性能上涨,但先看测试边界
Anthropic 公布的结果中,Fable 5.1 在 Terminal-Bench-Science 0.1 得到 52.6%,Fable 5 为 24.7%;Terminal-Bench 4.0 为 55.8%,CursorBench 3.2.0 在 Max effort 下为 73.4%。AutomationBench 也从 Fable 5 的 17.1% 提高到 31.4%。这些数字说明模型在长链路科研、编程和业务自动化任务上有明显进步。
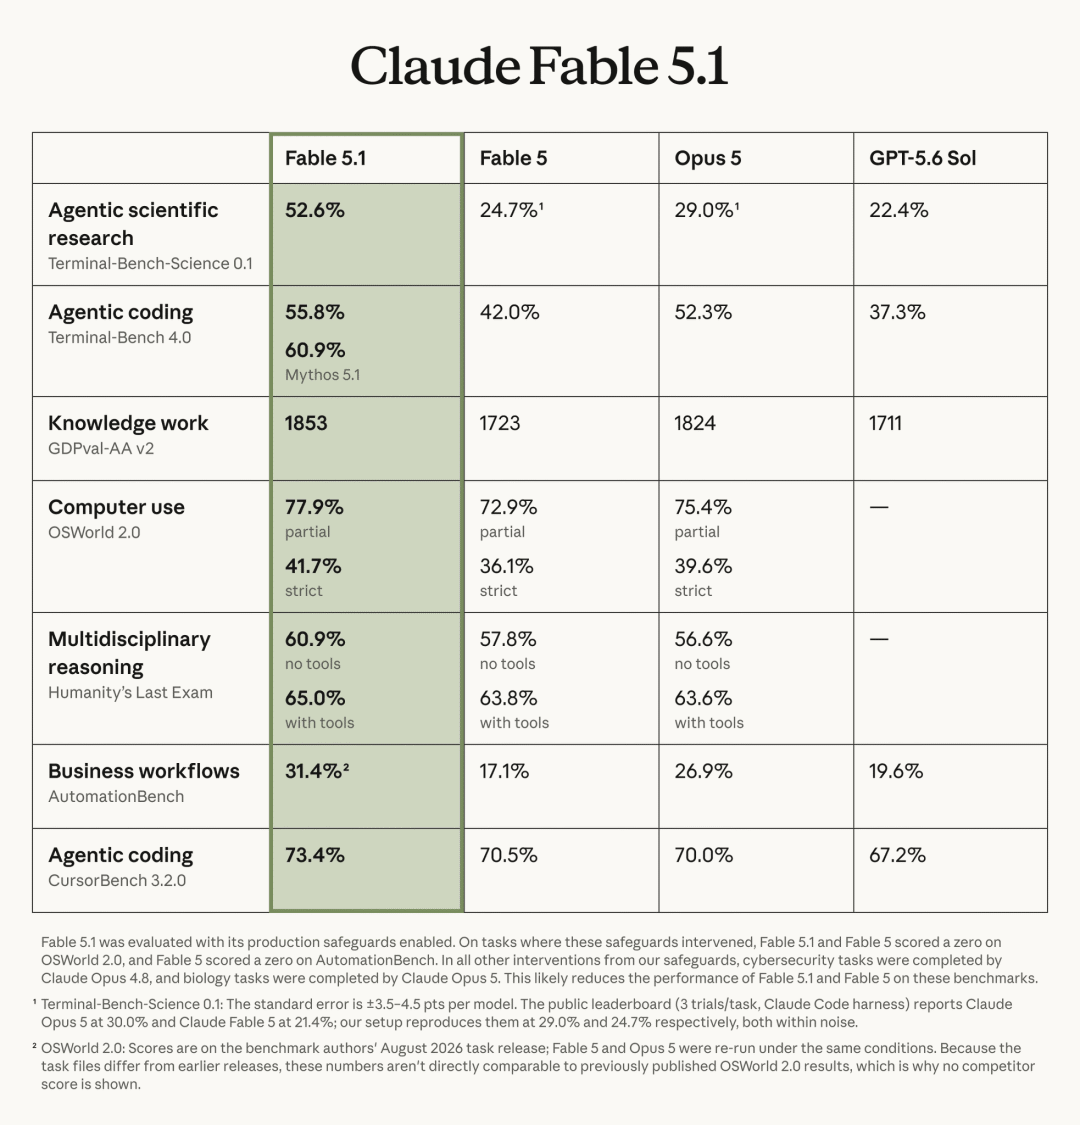
这里有一个容易被忽略的测试条件:Fable 5.1 以生产安全策略运行。部分被护栏标记的网络安全请求会由 Opus 4.8 完成,生物学请求会由 Opus 5 完成。公众号原文引用的独立评测称,约 4% 的输出 token 来自这种服务端回退。因此,基准分数既反映 Fable 5.1 本身,也受到实际路由策略影响。
对生产团队而言,带安全策略和回退的结果未必没有价值,因为这更接近真实服务;但它不能被解释为一个完全隔离、只运行 Fable 5.1 的纯模型分数。
价格悖论从哪里来
Fable 5.1 的基础价格没有变化:输入每百万 token 10 美元,输出每百万 token 50 美元。变化发生在 Prompt Caching:缓存读取从每百万 token 1 美元降到 0.25 美元。
| 计费项 | Fable 5 | Fable 5.1 | 变化 |
|---|---|---|---|
| 输入 token | $10 / 百万 | $10 / 百万 | 不变 |
| 输出 token | $50 / 百万 | $50 / 百万 | 不变 |
| 缓存读取 | $1 / 百万 | $0.25 / 百万 | 降低 75% |
Anthropic 使用 2026 年 8 月四周的实际数据估算:在默认 Effort 下,典型工作负载成本约降低 25%,上下文和工具调用密集的 Agent 工作负载最高可能降低约 45%。这个结论的前提,是同类负载中缓存读取占比较高。
公众号原文引用 Artificial Analysis 的任务级评测得出了另一面:Fable 5.1 Max 完成一个 Intelligence Index 任务平均花费 3.76 美元,Fable 5 Max 为 3.14 美元,Opus 5 Max 为 2.34 美元。原文给出的解释是,Fable 5.1 在该测试中的输出 token 约为 Fable 5 的 1.7 倍,额外输出抵消了缓存降价。
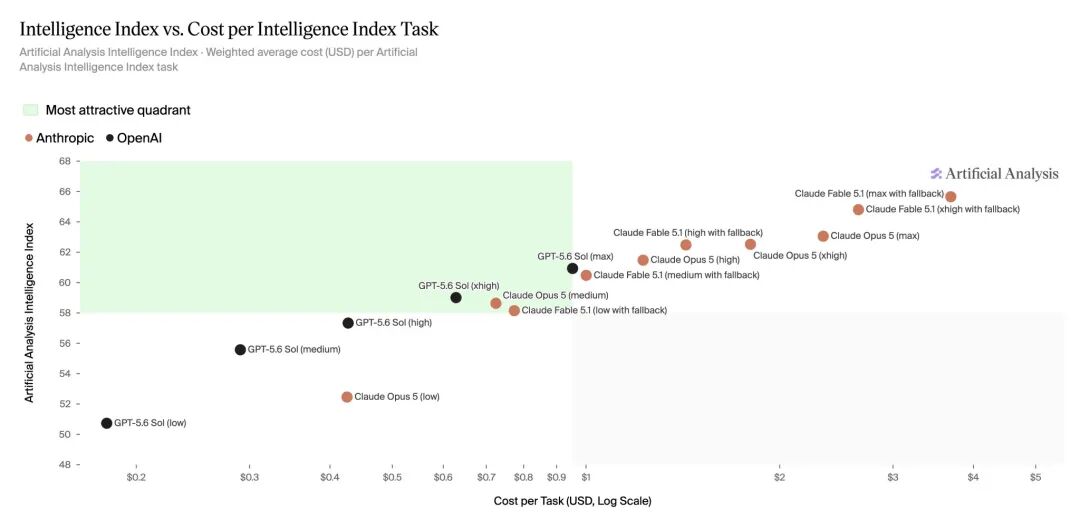
这两个结论并不矛盾。一个统计真实产品中以缓存为主的默认工作负载,另一个统计特定高强度基准任务的完整消耗。最终账单可以粗略拆成:
总成本 = 新输入 token × 输入单价
       + 缓存读取 token × 缓存单价
       + 输出 token × 输出单价
       + 重试与工具调用成本
缓存降价只影响第二项。由于输出单价是缓存读取的 200 倍,额外生成 1 个输出 token,需要节省约 200 个缓存读取 token 才能抵消。这正是“缓存便宜了,但任务反而更贵”可能发生的数学原因。
Effort 档位比 Max 更值得关注
Fable 5.1 提供 Low、Medium、High、Xhigh 和 Max 五个 Effort 档位。公众号引用的独立测试中,不同档位的总输出 token 从 1310 万到 1.437 亿,跨度接近 11 倍,而 Intelligence Index 从 58 提高到 66。
Max 的最后几分能力可能非常昂贵。原文数据显示,Xhigh 得到 65 分,单任务约 2.72 美元;Max 得到 66 分,单任务约 3.76 美元。也就是说,为最后 1 分多支付约 38% 的成本。在批量工作流中,这类边际成本会迅速放大。
把 Medium 或 High 作为默认档位,只在任务失败、验证不通过或问题价值足够高时升级到 Xhigh/Max。不要把 Max 当成无需判断的生产默认值。
Agent 任务:能力接近不等于经济性相同
在 Anthropic 公布的知识工作评测中,Fable 5.1 的 GDPval-AA v2 得到 1853 Elo,Fable 5 为 1723,Opus 5 为 1824。公众号引用的 Artificial Analysis 结果还显示,AA-Briefcase 中 Fable 5.1 与 Opus 5 接近,优势主要体现在分析质量和评分标准遵循,呈现质量则不一定更好。
这意味着选型不能只问“谁的分数最高”。至少还要同时观察:
- 完成率:任务最终是否通过自动验证或人工验收;
- 总 token:尤其是价格更高的输出 token;
- 墙钟时间:模型速度和工具等待时间;
- 重试次数:失败后重复执行可能比单次差价更贵;
- 人工介入:输出可读性和可审查性会影响真实交付成本。
Anthropic 发布页中的早期客户案例也支持这种按任务评估的方式。Cognition 表示会把部分 Opus 5 流量切换到 Fable 5.1,原因是代码审查等缓存密集负载更经济;Millennium 则报告 Fable 5.1 找到了一个多年未解决的罕见崩溃根因。这些案例说明它适合高价值、长时间的复杂任务,但不代表所有请求都应迁移。
EFS 解决的是数据控制,不是单纯降价
Fable 5 默认需要保留 30 天数据用于安全监测,这让金融、医疗和政府等受监管行业面临合规障碍。Enterprise Frontier Safeguards(EFS)的设计,是把活动数据存放在客户控制的 AWS、Azure 或 Google Cloud 环境中,并允许客户使用自己的加密密钥、访问策略和审计日志。
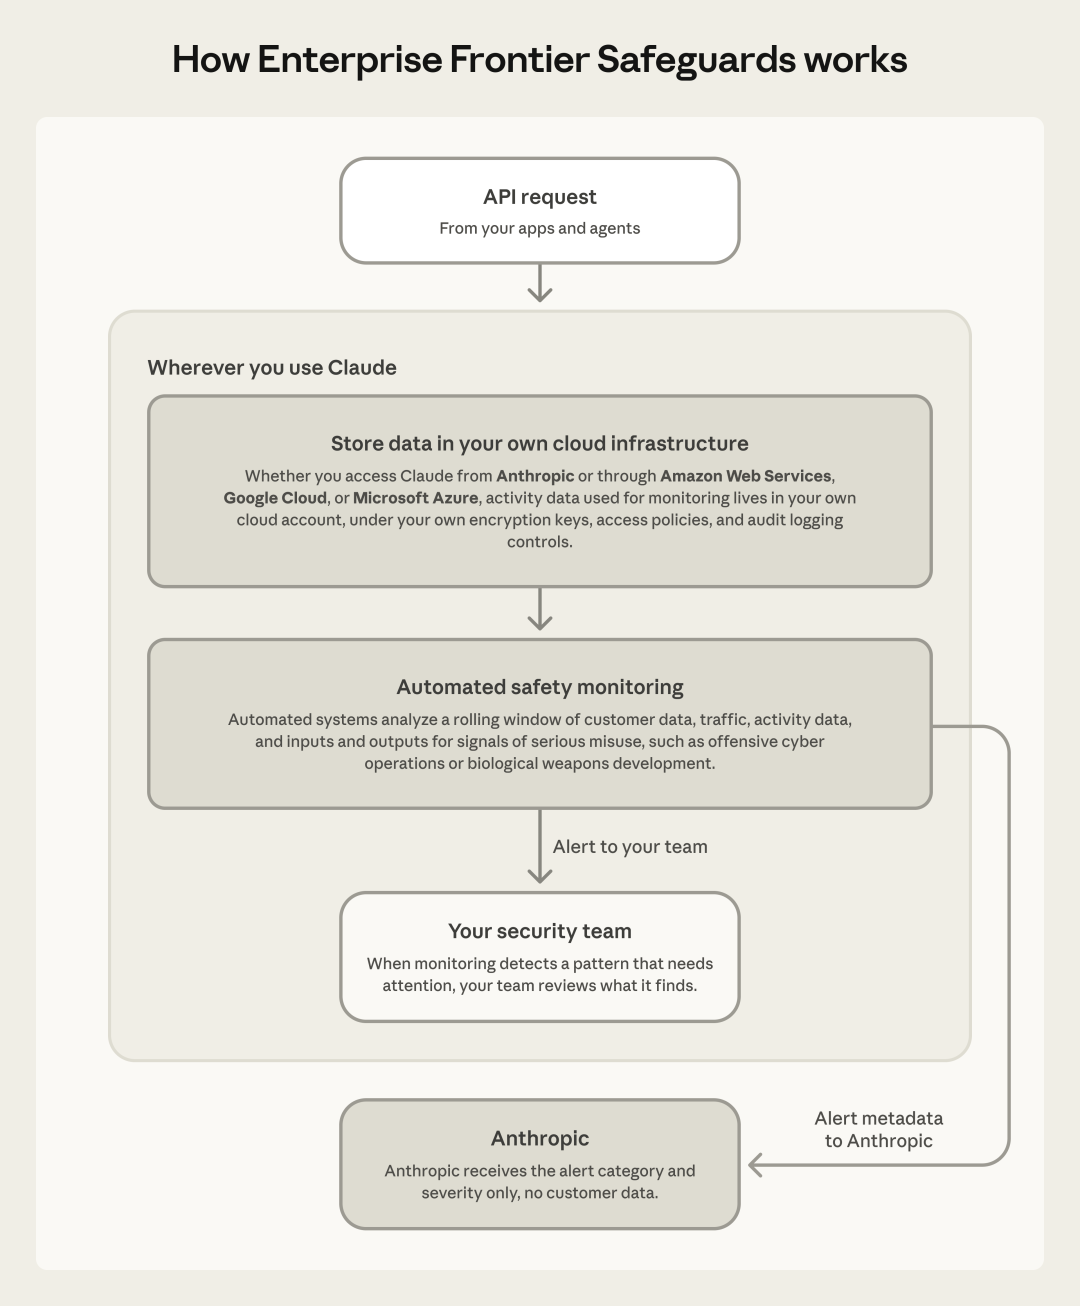
Anthropic 表示,自动系统会分析滚动流量窗口中的严重滥用信号,默认不需要 Anthropic 员工进行人工审核。EFS 本身不额外收费,也不改变模型价格和限流;但客户仍需承担云存储、读写和数据传输费用。该方案从 2026 年秋季开始分阶段上线,符合条件的客户在过渡期可以使用零数据留存。
科研演示展示了长任务能力
Anthropic 展示的科研案例不只是问答。Fable 5.1 使用 NASA 麦哲伦任务的雷达图像训练神经网络,为金星约三分之一表面重建高分辨率高程图。官方称,地图可见细节从原来的 10 至 20 公里提高到 2 至 3 公里,高度精度最多改善 25%,成果已按 Creative Commons 许可公开。
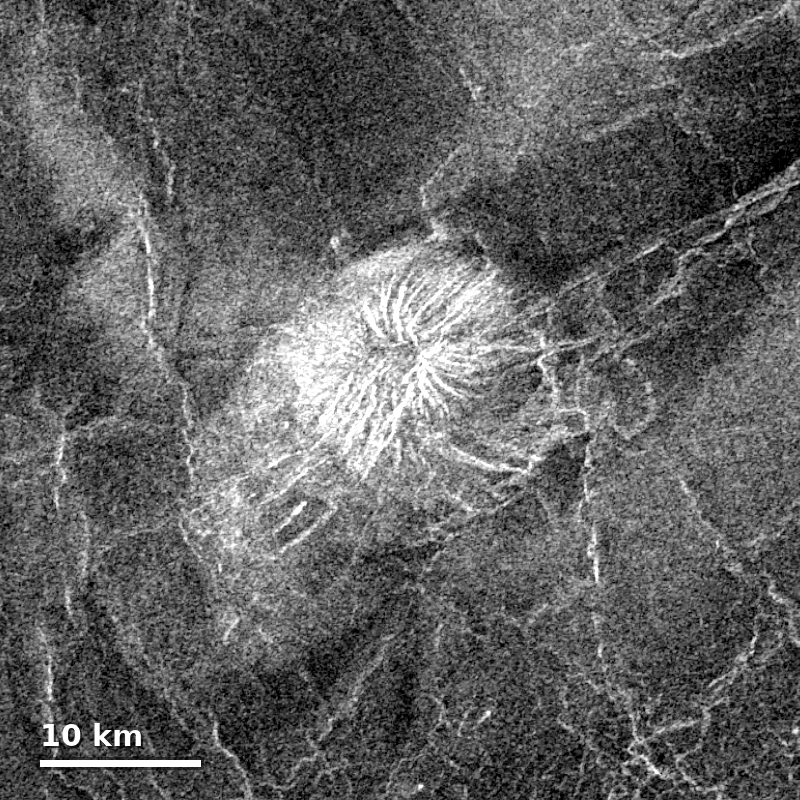
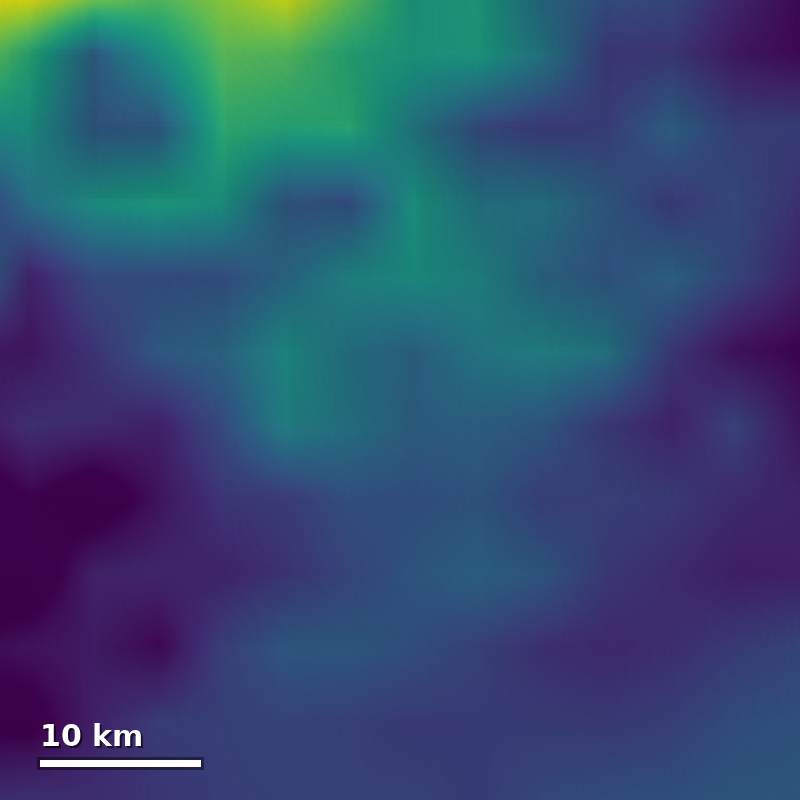
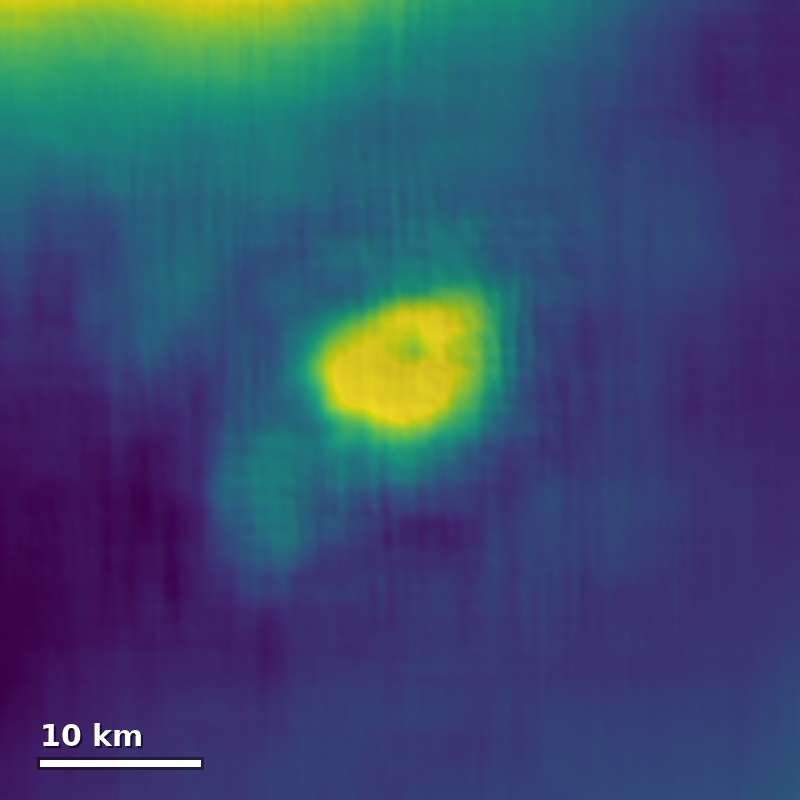
Mythos 5.1 的演示则包括蛋白质结合物设计,以及为七个开源深度学习模型编写 GPU Kernel、缓存中间结果。Anthropic 报告的推理加速范围为 1.4 至 2.5 倍,部分全基因组分析的预计 GPU 成本降低 30% 至 60%。这些是受控案例,并不意味着模型可以无监督替代科研验证,但它们体现了模型结合工具、代码和长时间执行的方向。
怎么判断是否值得切换
Fable 5.1 更适合复杂编码、长时间研究、跨工具 Agent 和高价值疑难问题。对短问答、简单文本转换或输出量很大的批处理任务,它的能力溢价可能不划算。
| 工作负载 | 建议 | 重点指标 |
|---|---|---|
| Claude Code 长任务、代码审查 | 优先小流量测试 Medium/High | 缓存命中率、通过率、总成本 |
| 复杂故障分析、研究任务 | 可升级 Xhigh,失败后再用 Max | 有效结论、人工复核时间 |
| 短问答、分类、格式转换 | 先比较更轻量模型 | 每千次请求成本、延迟 |
| 高输出内容生成 | 严格限制输出预算 | 输出 token、截断与重试 |
| 受监管企业数据 | 确认 EFS/ZDR 资格和上线阶段 | 存储位置、密钥、审计责任 |
最可靠的迁移方式,是从真实请求中抽取一组固定任务,同时记录质量、输入 token、缓存读取、输出 token、延迟和人工验收结果。可结合 Claude Messages API 接入指南设计最小评测,再到 Sublyx 模型广场确认当前可用模型和实际价格。
最终结论不是“Fable 5.1 一定更贵”或“一定省 25%”,而是:缓存密集型 Agent 可能明显受益,输出密集型高 Effort 任务则可能更贵。把模型价格表换算成每个成功任务的成本,才是上线决策真正需要的数字。
资料来源
- Anthropic:Introducing Claude Fable 5.1 and Claude Mythos 5.1,访问于 2026-09-02。
- Anthropic:Developing Enterprise Frontier Safeguards with our customers,访问于 2026-09-02。
- AI工程化 / winkrun:Claude Fable 5.1 发布:缓存读降价 75%,但实际更贵了,发布于 2026-09-02。